Демо 14 октября · фото, ошибки и стоимость · обновлено 13 октября 2026
Выбираем DINO. Проверяем пользу на новых витринах.
Основной кандидат — DINOv3 с малым классификатором. Первый цикл: новые сцены и точный отбор подсказок. Критерий решения — меньше времени на осмотр при контролируемых пропусках и ошибках.
Рекомендация для обсуждения. Направление продукта и новые запуски этим отчетом не утверждаются.
Фото P03 · сохраненный экспериментТри маленькие точки. Большая разница для осмотра.Открыть фото с находками ↗
Что выбираем и почему.
Рекомендация по следующему исследовательскому циклу. Рабочая демонстрация и продуктовая модель сохраняют свой отдельный статус.
Основной путь
DINOv3 + малый классификатор
В сохраненной серии дает сильный результат при небольшой задержке. На тех же 12 фото: DINO 36/40 и 1 учитываемая ошибка; YOLO26n 20/40 и 2 ошибки.
Проверить перенос и пользу
3,25 с/фото после загрузки модели. Разные истории подбора и черновая разметка ограничивают сравнение. Это основание выбрать кандидата, а не доказательство готовности.
Первое улучшение: отбор
Все четыре известных пропуска имеют исходные кандидаты. Проверим, можно ли вернуть полезные места, добавляя человеку максимум две подсказки на фото.
Порог нельзя просто снизить: поток предложений увеличивается примерно в десять раз.
Альтернативы по условию
AnyUp или более мелкая сетка — если остается проблема деталей. RF-DETR Small — самостоятельный претендент после проверки оборудования. LibreYOLO — существующий быстрый ориентир.
VLM не включаем обязательным этапом: сохраненный Qwen-верификатор не улучшил полноту на complete12.
Что показать новому пользователю.
Сценарий на 10 минут: понятная задача, конкретное крепление, честный пропуск и цена работы. Решение о пилоте принимается по пользе для осмотра.
Что считаем пустым. Одна функциональная позиция для украшения, а не свободный фон. На одной подставке может быть несколько позиций.
Что уже умеем. Открыть P03: три совпадения, затем увеличить каждое крепление без метки поверх него.
Где ошибаемся. Открыть P26: 4 известных пустых, 3 найдены, 1 пропущено; всего 5 точек, из них 1 на занятом и 1 в исключенной области. Открыть пропуск и каждую дополнительную точку.
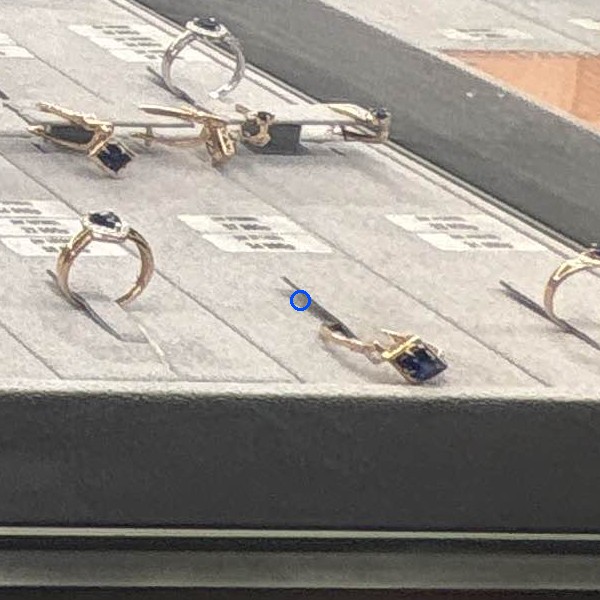
Что требует решения бизнеса. На P18 показать случай с кольцом внизу держателя. Согласовать, какое состояние требует действия сотрудника.
Сколько стоит и что дальше. Разобрать 150 тыс. фото в месяц, долю проверки человеком и первый этап бюджета. Назначить владельца новых фото и владельца приемки.
Вопросы, которые уже нужно закрыть
Цена месячного объема; возможность рассмотреть находку; понятный смысл счетчиков. Эти пункты переданы владельцем после звонка и учтены в этом обновлении.
На пилоте нужно согласовать
Какие крепления и ошибки приоритетны; сколько пропусков допустимо; кто проверяет спорные фото; срок ответа; пиковую нагрузку; источники новых независимых снимков. Это предложенная повестка, а не зафиксированные договоренности звонка.
Полная транскрипция сегодняшнего звонка пока недоступна через чтение чата. Запрос на извлечение цитат отправлен в исходный разговор. Остальные требования участников не приписываются им без подтверждения.
Сигнал есть. Цена отбора — ключевой вопрос.
Новый разбор сохраненных карт, без обучения и распознавания новых фото. Сравниваются три этапа одного DINO-конвейера на тех же 12 снимках.
Финальные подсказки
Текущий сохраненный результат
37 предложений 36 / 40 совпадений
Пул до финального решения
Порог 0,6
132 кандидата 38 / 40 совпадений
Исходные кандидаты
Порог 0,3 · после удаления дублей
1 341 кандидат 40 / 40 совпадений
+1 209 кандидатов ради двух пустых мест.
Две позиции с оценками 0,59 и 0,34 отсекаются входным порогом 0,6. Еще две проходят в пул, но не проходят финальное решение. Проверяем способ ранжирования, который даст полезные дополнительные подсказки при малой нагрузке на человека.
40/40 — геометрическое покрытие черновых меток кандидатами, а не 100% качество распознавания. В расширенном пуле 1 301 прочая точка: занятые позиции, фон, исключенные и неопределенные области. Финальный результат 36/40 остается прежним. Длины полос показывают количество кандидатов в единой линейной шкале.
Что уточнили после двух раундов с Fable
Отбор примерно 14 рецептов шел на 17 других фото. Полные 12 фото этот трек проверил позже; весь архив все равно многократно использовался в исследованиях.
Все четыре пропуска имеют исходные пики и переживают удаление близких дублей. Это не доказывает понимание состояния или единственную причину ошибки.
Прежний опыт с увеличением изображения усреднял признаки обратно до сетки 16 пикселей. Польза сохранения более мелкой сетки еще не измерена.
Закрытый тест открываем один раз после выбора метода. Если результаты уже просмотрены, следующий опыт требует нового закрытого набора.
Fable выступил критиком плана по текстовой сводке. Подсчеты проверены отдельно по сохраненным данным; обсуждение не является независимой проверкой фотографий человеком.
Ищем свободное крепление, а не отсутствие украшения.
Тонкий прозрачный держатель, блик и часть соседней подставки выглядят похоже. Именно здесь общий «разумный ответ» часто уступает точной локализации.
Найтикаждую нужную функциональную позицию
Различитьсвободное крепление, изделие и неоднозначность
Проверитьпоказать человеку конкретную область и сохранить решение
Отсутствие подсказок не означает «витрина в порядке». Подсчет всех изделий, соответствие планограмме и автоматические поручения не доказаны этими опытами.
Четыре подхода. Разные места риска.
Группируем по устройству системы, а не по бренду модели. Detector + embeddings — локальный классификатор, даже если в названии есть Gemma.
A
Только VLM
Гибкость есть. Полнота поиска слаба.+
Фото→Модель понимает и ищет→Точки + состояния
Что проверили
Luna, Haiku, Gemma, Qwen и Moondream в разных постановках. VLM получает целое фото или его фрагменты и должна сама найти нужные позиции.
Haiku broad11: 11 фотографий, 10 успешных завершений и 1 техническая ошибка. На трех фото со старыми 7 известными пустыми местами — ни одной подсказки «пусто».
Вывод для команды
Не выбирать основным массовым поиском по текущим данным. Оставить для помощи разметчику и объяснения сложного случая, если отдельная проверка покажет пользу.
Отдельный тест с уже указанными областями: Haiku 1/7 пустых, Luna 3/7, без ложных «пусто» на размеченных занятых. Он измеряет классификацию заданных целей, а не поиск на фото.
DINOv3 + Qwen: 36/40 найдено, как без Qwen, но ложных срабатываний 3 вместо 1. Gemma probe + Gemma 4 12B: 32/40 вместо 26/40, ложных 2 вместо 0.
Это две разные истории: один проверяющий добавил только ошибки на complete12; другой увеличил охват с ростом ошибок.
Вывод для команды
Встроить VLM во все проверки сейчас невыгодно по доказанной полезности. Выборочный вызов — гипотеза: нужна честная проверка, что маршрутизация находит сложные случаи.
Пропущенную на первом этапе позицию второй этап обычно не увидит. Измеряем поиск и итоговую классификацию отдельно.
C
Обучаемый детектор
Быстрый путь. Качество еще ограничивает.+
Фото / тайлы→YOLO / RF-DETR→Позиция + класс
Что проверили
На общем наборе из 15 фото: контроль YOLO26n 7/41, LibreYOLO9s 14/41. Учитываемых ложных срабатываний 0 у обоих; у Libre еще 2 точки в исключенных областях.
RF-DETR Small не дошел до оценки качества: первая попытка обучения завершилась нехваткой памяти.
Вывод для команды
Сохранить детектор как альтернативу для большой нагрузки. Libre — доступный быстрый ориентир. RF-DETR — один ограниченный технический опыт после отдельного допуска.
У Libre и контроля отличаются режим обучения, разрешение и калибровка уверенности. Рост 7 → 14 не доказывает чистое преимущество архитектуры.
D
Визуальные признаки → малый классификатор
Основной кандидат следующего этапа+
Фото→DINOv3 / Gemma embeddings→Обученный probe
Что проверили
DINOv3 dense probe: 36/40, 1 учитываемая ошибка и 3,25 с на фото в сохраненном измерении после загрузки модели. По всему архиву — 62/87.
YOLO26n + Gemma embeddings тоже относится сюда: вторая модель выдает признаки для локального классификатора, а не генерирует VLM-ответ.
Вывод для команды
Лучший баланс наблюдаемой полезности и времени в текущей серии. Сохранить рецепт и проверить перенос; не тратить следующий цикл на подбор десятков новых имен.
DINOv3 использует специальную лицензию Meta. Это не запрет коммерческого применения, но условия передачи и использования нужно учесть до доставки заказчику.
Куда отнести SAM, аномалии и сравнение с эталоном?
SAM 3 — возможный инструмент разметки/локализации, а не готовое правило «пустой держатель». SAM-LAD, ComAD, PSAD, CSAD, PatchCore и сравнение с эталоном вынесены в исторический реестр: для них важны нормальные примеры, соответствие сцен и дополнительные предпосылки. Некоторые выполнялись лишь частично, некоторые не запускались. Их нельзя объявить проигравшими в общем рейтинге.
Поставим числа на одинаковую основу.
Переключайте наборы. В каждой строке видны найденные пустые места, учитываемые ошибки и дополнительные точки, которые нельзя спрятать за «0 ложных».
Сохраненные результаты по выбранному набору
Метод
Найдено пустых
Ложные
Другие точки
Время / фото*
Ложные: «пусто» на занятой позиции + неразмеченная точка на фото с перечисленными позициями.
Другие точки: исключенные и спорные области, неразмеченные части, неизвестные метки и дубли. Это отдельные ограничения, не доказанные верные ответы.
Что именно измерено — и почему здесь нет общего процента «точности»
Разметка всех 29 фото создана ИИ и не подтверждена людьми: 2 623 позиции, 87 пустых, 2 522 занятых и 14 неизвестных. У 12 фото позиции перечислены с исключениями; у 17 разметка частичная. Даже набор из 12 фото содержит пустые места только на шести фотографиях.
Метрика засчитывает попадание точки с допуском; это не mAP и не проверка каждой границы рамки. Известные связанные сцены группировались, но весь архив уже был знаком исследованиям. Доверительные интервалы по независимым новым витринам еще не получены.
* Время — из локальных лабораторных измерений/оценок с разными границами учета. DINO 3,25 с — сохраненное среднее после загрузки; YOLO/Libre — теплый запуск; составные схемы — приблизительно. Это не задержка готового сервиса и не замер на NVIDIA. Не выводим из таблицы кратное преимущество по скорости.
Ансамбль 38/40 появился после просмотра теста. Его можно исследовать, но нельзя использовать как независимое подтверждение качества. Архивный all29 для YOLO + Gemma частично использовался при выборе варианта.
Дополнительная VLM не гарантирует улучшения.
На complete12 DINOv3 + Qwen оставляет 36 находок и меняет 1 ошибку на 3. Разумный следующий расход — проверить уже лучший простой вариант на новых сценах.
Находки DINO. Каждую можно рассмотреть.
Здесь показаны сохраненные ответы DINOv3 с малым классификатором. Слева — место на витрине, справа — крупный фрагмент оригинала без перекрывающей метки.
DINOv3 + малый классификатор36 из 40
Начните с примера:
P03
П1Синие метки — пустые места по разметке, которые пропустил DINO. Нажмите, чтобы рассмотреть.
Все точки модели
Пропуски DINO по разметке
Как читать точки и счетчики
На P16 «3 из 12» означает 3 найденных и 9 пропущенных, а не 12 пропусков. Это пропуски текущего DINOv3 с малым классификатором по черновой разметке. В основной группе из 12 фото — 4 пропуска из 40 известных пустых мест; во всем архиве из 29 фото — 25 из 87. P16 входит только в весь архив: разметка на нем частичная.
Точка — предположение модели о пустом креплении. «Найдено 3 из 4» означает: модель совпала с тремя из четырех пустых мест в черновой разметке. Четвертое место пропущено. При этом модель могла поставить дополнительные точки на занятых, исключенных или спорных участках. Они не повышают число найденных.
Совпадения проверяются единым алгоритмом с допуском к границам разметки. Цвет обозначает результат сравнения, не подтверждение человеком. 0 из 0 означает, что в разметке нет пустых мест; это не заключение «все в порядке». На частично размеченных фото реальных пропусков может быть больше.
Основное сравнение · 12 фото
На каждой карточке отдельно указаны найденные и пропущенные места. Например, P16: найдено 3 из 12 известных, пропущено 9. Фото выбираются по полноте разметки, а не по числу удачных находок. Новое распознавание не запускается.
Ошибки определяют следующий этап.
Следующий цикл должен улучшить отбор полезных подсказок и согласовать смысл действия для спорных случаев.
Скрытый язычок за серьгами
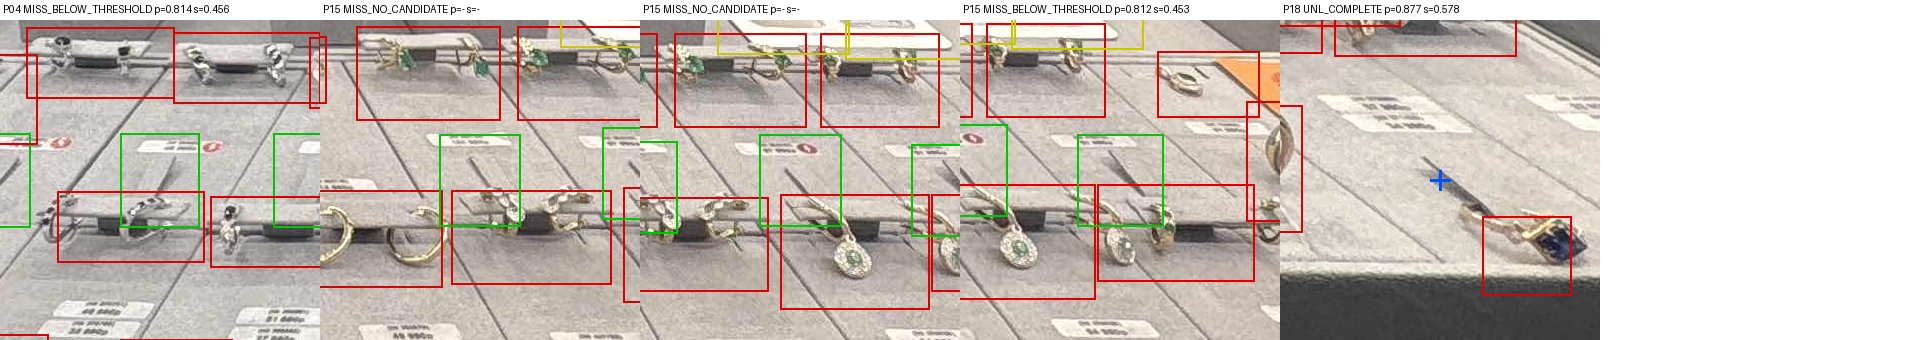
Четыре пропуска на P04 и P15. Все четыре имеют исходные кандидаты. Два отсекаются порогом входного пула, еще два — финальным порогом. Причина слабого сигнала и польза дополнительного VLM не установлены.
В следующую разметку включить независимые крепления на одной подставке, мелкие детали и перекрытия. Проверять полный кадр.
Кольцо упало. Место пустое?
Спорная точка P18 учитывается как ошибка. Визуальный факт и бизнес-правило различаются: товар рядом может означать «поправить выкладку», а не «пополнить».
До проверки согласовать три действия: пополнить, поправить, уточнить. Человек решает неоднозначность.
RF-DETR Small: сломался запуск. Качество неизвестно.
Независимый разбор сопоставил сохраненные журналы, установленную версию 1.11.2 и официальную документацию. Нулевой результат в техническом отчете не является нулевой полнотой распознавания.
Старт640 px · microbatch 2 · накопление 2 Переменное разрешение: 11 размеров от 480 до 800
66,1 сНехватка памяти Metal во время обратного прохода
Остановка0 завершенных эпох · нет checkpoint Качество и скорость распознавания не измерены
Граница конкретной попытки
9,47 GiB Metal
7,48 GiB выделено MPS + 1,96 GiB других выделений. Дополнительные 72 MiB не поместились. Это отдельный лимит GPU-памяти, не первоначальный потолок RSS процесса 12 GiB.
Одна следующая попытка: конкретное предложение, еще не запускалось
Сохранить RF-DETR Small и 640 px. Уменьшить microbatch до 1, накопление увеличить до 4, выключить multi-scale, включить gradient checkpointing. Сохранить защитный лимит памяти. Внутри единственной новой попытки контролировать первый полный цикл обучения и валидации на реальных данных; при нехватке памяти остановиться без автоматического повтора.
Ожидаемое снижение памяти — гипотеза, а не доказанный результат. Удержание выделенной памяти на разных размерах могло способствовать сбою; сам журнал доказывает только достижение лимита. Убирать защиту памяти как способ «починить» запуск не предлагаем.
В чате заявлены Ubuntu 24.04 / 64 GB RAM и Windows с NVIDIA («4090ti»). Точная модель GPU, VRAM и доступ не проверены. Поэтому бюджет использует уже имеющееся оборудование, но не обещает его скорость и не предполагает автоматическую установку или удаленный запуск.
Один выбранный претендент на цикл. Решение принимаем на открытых данных до финального закрытого сравнения.
Детали: мелкая сетка / AnyUp
AnyUp уточняет карту признаков по исходному изображению. Есть вариант без CUDA-зависимости NATTEN. Качество и совместимость с нашим запуском не измерены.
Когда выбирать: если при фиксированном числе подсказок сохраняются ошибки на мелких креплениях. Сравнить один выбранный способ с простой интерполяцией, сохранив физический размер контекста и одинаковое обучение малой головы.
Работать по фрагментам: полная попиксельная карта 4032 × 3024 с 768 признаками в FP32 потребовала бы около 34,9 GiB только на выход. Репозиторий AnyUp — CC BY 4.0; происхождение конкретных весов проверить перед запуском.
Детектор: RF-DETR Small
Когда выбирать: если важнее проверить альтернативную архитектуру и доступна подтвержденная конфигурация оборудования. Один fit и одна оценка на общем наборе; технический успех и качество считать отдельно.
Сохраненный сбой MPS не исключает модель из рассмотрения. Выбран отдельный компьютер с Ubuntu 26.04 и RTX 4070 Ti; видеопамять и готовность CUDA нужно подтвердить на устройстве. Покупку GPU и облака не включаем в базовую смету.
NAF, JAFAR и ViT-Up оставляем в исследовательском резерве: дополнительные зависимости, совместимость признаков или неуточненная лицензия. Их локального сравнения не было.
Новая попытка после уже открытого финального теста означает новый проверочный набор и пересмотр бюджета. Этот отчет не запускает выбранную ветку автоматически.
Инструмент для работы не выбирает модель за нас.
Из чата «Разбор YOLO и Ultralytics» берем полезные варианты, но не превращаем смену платформы в обязательный проект.
Инструмент
Роль
Решение сейчас
X-AnyLabeling
Локальная разметка и просмотр моделей. Графическое обучение документировано для Ultralytics.
Кандидат для разметчика; RF-DETR обучать отдельно. Не считать наличие модели в каталоге готовым обучением.
FiftyOne
Исследование датасета, сравнение предсказаний, разбор ошибок.
Подключать, когда текущий просмотр мешает разбору данных. В пилоте достаточно сохраненного реестра и фото.
Geti / Roboflow Workflows
Управление модельным циклом / сборка цепочек обработки.
Отложить выбор платформы до измерения простой цепочки. Условия self-hosting и отдельных моделей проверяются отдельно.
Текущий Go-продукт
Очередь фото, история, доказательства, исправления человека.
Сохранить интерфейс и заменить исполнителя только после принятой проверки. Не переписывать продукт вокруг библиотеки.
Лицензии входят в решение
RF-DETR Small: Apache-2.0. LibreYOLO9s: MIT у конкретных весов. DINOv3: специальные условия Meta, в том числе передачи и допустимого использования. Ultralytics: AGPL-3.0 / Enterprise. Экспорт в ONNX сам по себе условия не меняет. Проверка цепочки зависимостей и способа поставки — часть этапа, не утверждение юридической готовности.
Следующий шаг: DINO в рабочем процессе.
Демо выше показывает результаты выбранного исследовательского метода. Следующий пилот должен проверить его пользу на новых фото и включить находки в осмотр сотрудником.
Пакет фото→Находки DINO→Осмотр человеком→Подтвержденное действие
Сотрудник видит вероятную проблему и ее место, принимает решение, а команда измеряет пропуски и стоимость проверки. Автоматическое заключение «все хорошо» пока не входит в обещание.
Что уже есть в прежнем прототипе на Luna
Отдельный сохраненный просмотр открывает 29 фото: 23 завершенных задания и 6 с частичными материалами. В нем 50 предварительных EMPTY, 124 UNKNOWN и 9 областей без окончательного решения. Эти числа — ответы Luna, а не оценка точности DINO.
Галерея этого отчета использует точки DINOv3. Перенос DINO в исполняемый продукт еще не выполнен; прежний прототип остается отдельным источником опыта по истории и исправлениям.
Следующие эксперименты. Каждый заканчивается решением.
Сначала закрываем риск переноса и нагрузки на человека. Дополнительный метод выбираем по найденной причине ошибок.
Новые сцены и воспроизводимая база
Гипотеза: выбранный DINO сохраняет полезность на новых физических витринах. Человек проверяет полноту разметки и смысл «пустой позиции». Фиксируем модель, преобразования, пороги и правила неизвестности для нового фото. Разделяем сцены на разработку и закрытое подтверждение.
Результат: проверенные данные, базовый протокол и один итоговый закрытый прогон после выбора претендента. Если меток, типов креплений или независимых сцен недостаточно — вывод «данных недостаточно».
22–32 ч включая итоговую оценку
Полезные дополнительные подсказки
Гипотеза: отбор с учетом крепления и соседних товаров полезнее простого порядка по оценке модели. Сравниваем на одних кандидатах; максимум две дополнительные подсказки на фото. Обучение ранжирования, если потребуется, выполняется только на данных разработки.
Продолжаем, если: при одинаковом лимите получаем больше полезных мест без роста ошибок и сокращаем полное время проверки. Четыре знакомых пропуска служат диагностикой, а не критерием приемки.
8–12 ч проверка и замер времени
Развилка: нужен ли новый метод?
По открытым данным выбираем одну условную ветку: мелкая сетка / AnyUp либо RF-DETR. Если простой отбор уже дает пользу, эту статью пропускаем. При отсутствии улучшения в пределах зафиксированного бюджета прекращаем ветку.
Закрытая проверка: после выбора замораживаем базу и максимум одного претендента и сравниваем их один раз на нетронутых сценах. База и метод получают одинаковые исходные фото и правила оценки.
Отдельное решение до закрытого теста
Ограниченный пилот с пользователями
Только после прохождения критериев: подключить выбранный рецепт к существующему сценарию проверки, измерить работу на новых фото и собрать причины исправлений. Система показывает подсказки и неопределенность; человек подтверждает действие.
Стоп: если полная проверка не становится быстрее, пропусков больше или технические сбои мешают работе. Массовое внедрение, интеграции и эксплуатационный SLA — отдельная смета.
16–24 ч условный следующий этап
Разделяем данные до начала
РазработкаАрхив + новые открытые сцены. Здесь разрешен подбор.→ФиксацияОдна база + один претендент. Без дальнейшего изменения.→Закрытое подтверждениеДругие физические сцены. Один совместный прогон.
План сбора: ориентир 10–12 физических сцен вместо множества соседних ракурсов. Все ракурсы и парные съемки одной сцены остаются в одной части. Сцены разработки и подтверждения не пересекаются; число магазинов и типов держателей показываем в отчете.
Предлагаемые критерии допуска к пилоту
Рабочие цели для согласования до закрытого прогона. Они не достигнуты, не утверждены и не являются гарантией статистической надежности.
≥85% найденных размеченных пустых позиций
≥95% полезных финальных подсказок среди всех выданных
≤0,1 ошибочной «пустоты» на занятом месте на фото
≥30% сокращение медианного времени полного осмотра
Нагрузка: максимум 2 дополнительные гипотезы на фото. Они явно требуют проверки и учитываются отдельно от финальных подсказок.
Надежность: не более 5% технически неуспешных фото; сбои и UNKNOWN видны. Пропуски после проверки с помощником не выше ручного контроля.
Данные: ориентир ≥100 пустых и ≥1 000 занятых позиций в закрытой проверке. Недостаток данных не считается успешным прохождением; дополнительный сбор требует решения по бюджету.
Подсчет: полезна только однозначная находка, подтвержденная человеком. Ошибки, дубли и неразрешенные финальные подсказки остаются в знаменателе precision. Отдельно показываем долю фото без пропусков и ложных подсказок.
Время включает поиск пропущенных мест, исправления и повторные просмотры. Ручной и ассистированный осмотр распределяем между людьми и сценами, чтобы запоминание фото не создавало видимой экономии. Отчет по каждой сцене и неопределенности обязателен: 100 позиций из одной витрины не заменяют независимые сцены. Провал критерия означает разбор и новое решение, без автоматического следующего опыта.
150 тысяч фото в месяц. Сколько стоит обработка?
При одинаковом количестве токенов Luna и Haiku стоят одинаково; выбранный облачный Qwen близок к ним. Главный множитель — сколько фрагментов проверяем и насколько длинный ответ получаем.
API: три сценария при одинаковом расходе, без кеша и скидок
Сценарий на одно фото
Luna
Haiku 5.5
Qwen3.5-Flash
Короткий: 12 000 вход + 1 000 выход
$255 / мес.
$255 / мес.
$240 / мес.
Рабочая гипотеза: 30 000 + 4 000
$750 / мес.
$750 / мес.
$690 / мес.
Много фрагментов: 100 000 + 30 000
$3 750 / мес.
$3 750 / мес.
$3 300 / мес.
Это сценарии, а не измеренная цена точного распознавания. Вход включает изображения и инструкции, выход — оплачиваемые токены ответа и reasoning. Одинаковая фотография может давать разный расход у разных моделей. Числа суммируются по всем вызовам для одного фото; отдельный запрос Haiku не превышает 100 тыс. входных токенов. Налоги, комиссии и региональные надбавки не включены.
Курс 100 ₽/$ — изменяемое допущение, не текущая котировка. Для гибрида доля VLM снижает только API-часть: обработка локальной моделью и проверка человеком остаются.
Что показывают наши сохраненные запуски
Источник
На 150 тыс. фото / мес.
Что это означает
Luna · 12 фото, 261 вызов $0,201952175 / 12
≈ $2 524
Оценка по API usage. 9 полных и 3 частичных результата. Экстраполяция попыток, не гарантия полезного результата.
Luna · продуктовый пакет из 16 фото $0,31304195 / 16
≈ $2 935
14 успешных и 2 неуспешных завершения. Похожий порядок затрат у многократной проверки фрагментов.
Haiku · токены опыта на 11 фото, пересчет по текущему API
≈ $511
Один полнофотографический ответ; другой метод, 10 успешных и 1 ошибка. На старых 7 известных пустых местах новых подсказок нет. Дешевизна без качества не решает задачу.
У Haiku сохраненный CLI сообщает $1,59622 за 11 попыток, а пересчет token usage по официальным тарифам дает $0,037458. Основа CLI-цены неизвестна; ее нельзя выдавать за API-счет. Расчет $511 использует 22 обычных входных, 32 639 записанных в кеш и 66 751 выходной токен, включая thinking. Счет провайдеров не проверен.
Qwen локально: API $0, но GPU занят
В наших опытах — Qwen3.5-4B, проверяющий кандидатов DINO. Это другая модель, чем облачный Qwen3.5-Flash. Сохранено около 30 с/фото на прежней машине: арифметически 1 250 часов работы на 150 тыс. фото. На RTX 4070 Ti скорость еще не измерена.
DINO без Qwen: сохраненные 3,25 с/фото соответствуют примерно 135 часам. Эти числа не являются сравнением на новой NVIDIA. Один компьютер за 30 дней имеет 720 часов; при плановой загрузке 70% среднее время должно быть ≤12,1 с/фото.
Проверка человеком может стоить больше API
При проверке 10% фото по 30 секунд — 125 часов в месяц. При расчетной ставке 600 ₽/ч это 75 000 ₽. Проверка каждого фото по 30 секунд — 1 250 часов и 750 000 ₽. Обе величины — допущения для пилота.
Полная цена: API + оборудование/аренда + электричество + хранение + поддержка + проверка человеком. Внутренний GPU не бесплатный: амортизация и загрузка должны войти в смету.
Тарифы проверены 13.10.2026: GPT-6 Luna $0,10 / $0,50 за 1 млн входных / выходных токенов; Haiku 5.5 $0,10 / $0,50 при входе ≤100 тыс. на запрос; Qwen3.5-Flash, Singapore / International $0,10 / $0,40. Другие регионы и версии Qwen имеют другие цены. Облачный Qwen в этой серии не оценивался. Скидки Batch не заложены в базовую смету.
Бюджет открываем по результатам этапов.
Первый цикл: 30–44 человеко-часа. Дальнейшие строки — отдельные плановые допущения для выбора сценария, не обязательства и не автоматическое продолжение.
Этап / условие
Труд, ч до резерва
Вычисления лимит
Бюджет с резервом
Первый цикл к решению команды113 000–163 400 ₽
Данные + отбор подсказок + итоговая оценка. По его результату — продолжить, упростить или остановить.
Выбранный сценарий целиком113 000–163 400 ₽
Для каждой включенной строки: часы × ставка × (1 + резерв) + лимит вычислений. Резерв применяется к труду один раз; вычисления прибавляются один раз на этап. 2 000 ₽ и 3 000 ₽ первых двух строк вместе дают прежний лимит 5 000 ₽. Цифры включают полные вычислительные лимиты, фактический расход может быть ниже.
Границы сметы и отличие от предыдущей версии
113–163,4 тыс. ₽ — новый первый цикл, а не скидка на прежнюю программу 221–235,4 тыс. ₽. Условные ветки и пилот оцениваем отдельно. Их диапазоны — новая предварительная оценка команды; Fable обсуждал только первый цикл.
Доступ к магазинам, поездки и закупки, оборудование, платные платформы, коммерческие лицензии, массовое внедрение, новые интеграции и поддержка после пилота не включены. Если данных недостаточно в пределах часов, останавливаем оценку и согласуем дополнительный сбор.
Одна дополнительная ветка выбирается на разработке до закрытого теста. После открытия теста понадобится новый закрытый набор; его стоимость не включена в строки повторного исследования.
Ценность — во времени, которое вернулось команде.
Результаты экспериментов пока не доказывают рост продаж или экономию фонда оплаты труда. Ниже — сценарий ценности освобожденного времени; все входы нужно измерить на пилоте.
Изменение времени / месяц
Условная ценность после расходов
Возврат выбранного бюджета в сценарии
Формула: фото × (ручной осмотр − осмотр с помощником) / 3 600 × цена часа − ежемесячные расходы. Стоимость времени — не денежная прибыль. Начальные 80 000 ₽ расходов — пример: 75 000 ₽ API по средней гипотезе выше и 5 000 ₽ прочих расходов; эксплуатационная смета еще не измерена. При изменении API-сценария пересмотрите это поле. Повторные проверки и поиск пропусков должны входить в замер; отрицательный результат не скрывается.
Что уже знаем о расходах, а что еще нет
Сохраненный запуск all29 использовал 275 удаленных и 15 локальных новых вызовов, оценка API по usage — $0,21865425, 793,470 с работы серии. Часть старых успешных результатов переиспользована; это не цена полного нового анализа 29 фото. Invoice, полная стоимость локальных вычислений и работы команды неизвестны.
Локальная модель убирает обязательный API-вызов на каждую позицию, но не делает обработку бесплатной. Нужны замеры загрузки GPU, обслуживания, проверки человеком и цены ошибочного решения. Доля выборочных VLM-вызовов еще не установлена.
Все прошлые попытки остаются в картине.
Старый реестр E01–E34: 25 диагностических выполнений, 1 технический неуспех, 1 остановка владельцем, 7 без полного запуска. Это не 34 принятые модели.
ID
Метод
Фактический статус
Пустые на заданных областях
Ложные «пусто»
Реестр — снимок 7 октября, не последняя оценка текущих весов. Заданные области, частичные локализации, разные наборы и невыполненные предпосылки не образуют честного общего рейтинга. Старый E32 не заменяет неудавшийся новый RF-DETR Small; E01 не равен более позднему dense DINOv3.
Поздние проверки и технические серии сверх E01–E34
Шаблоны ECC, HOG и маленькая CNN: ограниченные проверки на известных областях, без подтвержденного переноса на пустые позиции новых сцен.
Haiku target40 / broad11: классификация заданных целей и отдельный поиск по полному фото; результаты нельзя склеивать.
Claude t1 / t2 / t3: Gemma dense, DINO dense и YOLO + embeddings. Их метрики вынесены в основную сравнительную таблицу.
YD: отдельная серия YOLO26n / LibreYOLO9s / RF-DETR Small на 10 train / 4 validation / 15 evaluation.
Продуктовые и нагрузочные серии Luna: пригодность просмотра, сохранность, параллельность, задержки и ошибки сервиса. Они не подтверждают качество DINO и не заменяют новый закрытый тест.
История экспериментов неполна как единый стандартизированный benchmark. Этот отчет сохраняет группы и проверенные конечные статусы; не суммирует вложенные варианты и повторно используемые вызовы в выдуманное общее число опытов.
Решение для нашей команды
Сначала доказать пользу. Затем расширять вложения в проект.
Выбор сейчасDINOv3 + малый классификатор. Новые сцены и точный отбор подсказок.
Условная развилкаОдин претендент: детали через мелкую сетку / AnyUp или отдельная проверка RF-DETR.
Первый бюджет113–163,4 тыс. ₽ при выбранных плановых допущениях. Дальше — по результату.
После решения команды: назначить владельца данных и зафиксировать бюджет, протокол и допуск на новые запуски. Текущий отчет ничего не обучает и не меняет работающий демонстрационный просмотр.
Обновление 13 октября 2026 после собственного ресерча и двух текстовых обсуждений с Claude Fable 5 / medium. Обновление к демо: 29 фото, 81 точка и 25 пропущенных меток связаны с исходным алгоритмом оценки; для каждого подготовлен фрагмент оригинала. Полная транскрипция звонка пока не получена. База: 135 проверок и 102 файла прежнего аудита. Дополнение: 15 снимков публичных источников и 50 проверок расчетов, источников и ответов. Новых запусков распознавания и обучения не было.
Локальные пути исходных рабочих журналов не публикуются. В данных приведены имена источников и SHA-256; опубликованная версия не содержит локальных путей, приватных запросов и служебных данных обсуждения.